
Super Memory
Super Memory es un sistema de memoria desarrollado de forma independiente por Breezell. Utiliza dos modelos integrados de Breezell para extraer información útil de las conversaciones. Los nombres exactos de estos modelos no se hacen públicos.
La extracción se realiza mediante la canalización interna de modelos de Breezell y no consume tokens del modelo configurado por el usuario ni reduce su cuota de tokens.
Qué puede extraer Super Memory
Super Memory puede organizar la información extraída en varios tipos:
- Memory: Datos estables, preferencias, instrucciones permanentes y decisiones que pueden resultar útiles más adelante.
- Skill: Métodos o flujos de trabajo reutilizables identificados durante una tarea.
- Experience: Resultados, aprendizajes y conocimientos prácticos obtenidos de trabajos anteriores.
- Trajectory: Evolución de una tarea, decisión u objetivo a lo largo del tiempo.
- Resource: Archivos, enlaces, herramientas o material de referencia útil relacionado con el trabajo.
El sistema extrae y clasifica automáticamente estos elementos a partir de las conversaciones para recuperarlos como contexto pertinente en interacciones posteriores.
Explorar y filtrar memorias
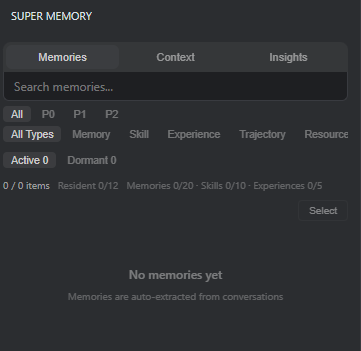
El panel ofrece las siguientes vistas y controles:
- Memories, Context e Insights: Permiten alternar entre las memorias extraídas, el contexto reunido y los análisis generales de la memoria.
- Búsqueda: Permite localizar entradas guardadas mediante texto.
- Prioridad: Filtra por P0, P1 o P2, o muestra todas las prioridades.
- Tipo: Filtra por Memory, Skill, Experience, Trajectory o Resource.
- Estado: Separa las entradas Active de las entradas Dormant.
- Contadores de capacidad: Muestran el número total de elementos y la capacidad utilizada por las entradas residentes, las memorias, las habilidades y las experiencias.
- Select: Activa el modo de selección para administrar entradas concretas.
Si todavía no hay entradas, el panel indica que las memorias se extraerán automáticamente de las conversaciones. A medida que continúe el uso, los elementos útiles podrán aparecer aquí sin que el usuario tenga que escribirlos manualmente.
Ventajas principales
Super Memory combina la extracción automática con una recuperación eficiente y altamente controlable:
- Extracción potente: Dos modelos internos de Breezell analizan las conversaciones y convierten la información útil en entradas estructuradas de Memory, Skill, Experience, Trajectory y Resource, sin necesidad de introducirlas manualmente.
- Recuperación eficiente: El tipo, la prioridad, el estado, la antigüedad y el índice de memoria compilado ayudan a limitar la recuperación a la información pertinente para la tarea actual.
- Inyección de contexto controlable: La vista Context muestra la instantánea inyectada en el turno actual, la vista previa del índice para el siguiente turno y su tamaño estimado en tokens.
- Control explícito del ciclo de vida: Las prioridades P0 permanente, P1 de 30 días y P2 de 7 días se combinan con los estados Active y Dormant para conservar los conocimientos importantes y limitar la duración de la información temporal.
- Estado del conocimiento observable: El estado de compilación, las versiones de origen y compilador, los recursos obsoletos, los errores, las verificaciones, las correcciones, la actualidad y los elementos sin sincronizar permiten inspeccionar el sistema.
- Control de tokens: La extracción no consume tokens del modelo configurado por el usuario. La memoria recuperada que se inyecta en una solicitud pasa a formar parte de su contexto; la vista previa y las estadísticas de ahorro hacen visible este uso.
Contexto y control de recuperación
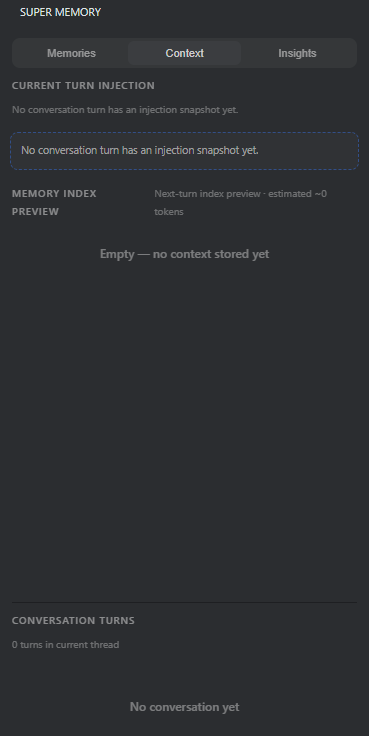
La vista Context muestra cómo participa la memoria en las conversaciones:
- Current Turn Injection: Muestra la instantánea de memoria inyectada en el turno actual. Si todavía no existe, el panel muestra claramente un estado vacío.
- Memory Index Preview: Presenta el índice preparado para el siguiente turno y estima su tamaño en tokens.
- Conversation Turns: Muestra el número de turnos del hilo actual y permite revisar la actividad de memoria por turno.
Estos controles permiten comprobar si se ha inyectado memoria, qué se está preparando para el siguiente turno y cuál será aproximadamente el coste de contexto.
Información y estado del sistema
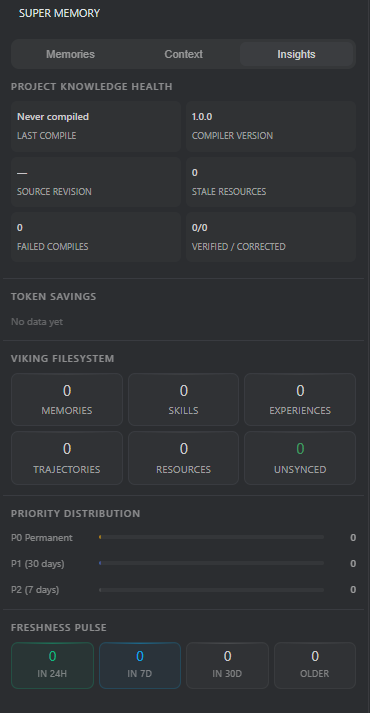
La vista Insights resume el estado y la eficacia del sistema de memoria:
- Project Knowledge Health: Muestra la última compilación, las versiones del compilador y de origen, los recursos obsoletos, las compilaciones fallidas y los totales verificados o corregidos.
- Token Savings: Muestra el ahorro de tokens cuando existe suficiente actividad registrada.
- Viking Filesystem: Presenta los recuentos de Memories, Skills, Experiences, Trajectories, Resources y elementos Unsynced.
- Priority Distribution: Muestra la distribución de entradas P0 permanentes, P1 de 30 días y P2 de 7 días.
- Freshness Pulse: Agrupa el conocimiento actualizado en las últimas 24 horas, 7 días, 30 días o en un periodo anterior.
Context e Insights permiten ver con claridad qué extrae Super Memory, qué información puede recuperar y si el conocimiento almacenado se mantiene actualizado y en buen estado.
Memorias activas e inactivas
Las memorias activas permanecen disponibles para recuperarse cuando sean pertinentes. Las memorias inactivas se conservan, pero se separan del conjunto activo, lo que mantiene centrado el contexto actual sin perder información que pueda resultar útil más adelante.
Demostración: convertir una reparación en memoria reutilizable
Este ejemplo utiliza un administrador de tareas HTML con errores intencionados para mostrar cómo Super Memory convierte una breve sesión de reparación en conocimiento reutilizable.
La solicitud pide a la IA que inspeccione todo el código y corrija la creación, eliminación y finalización de tareas, los filtros, los contadores, la persistencia en localStorage, la entrada mediante teclado y la eliminación de tareas completadas, sin cambiar la interfaz ni el comportamiento previstos.
1. Inspeccionar y reparar el administrador de tareas
Breezell inspecciona el código, identifica las causas raíz compartidas, corrige la implementación y verifica el flujo completo, en lugar de tratar cada síntoma visible como un error independiente.
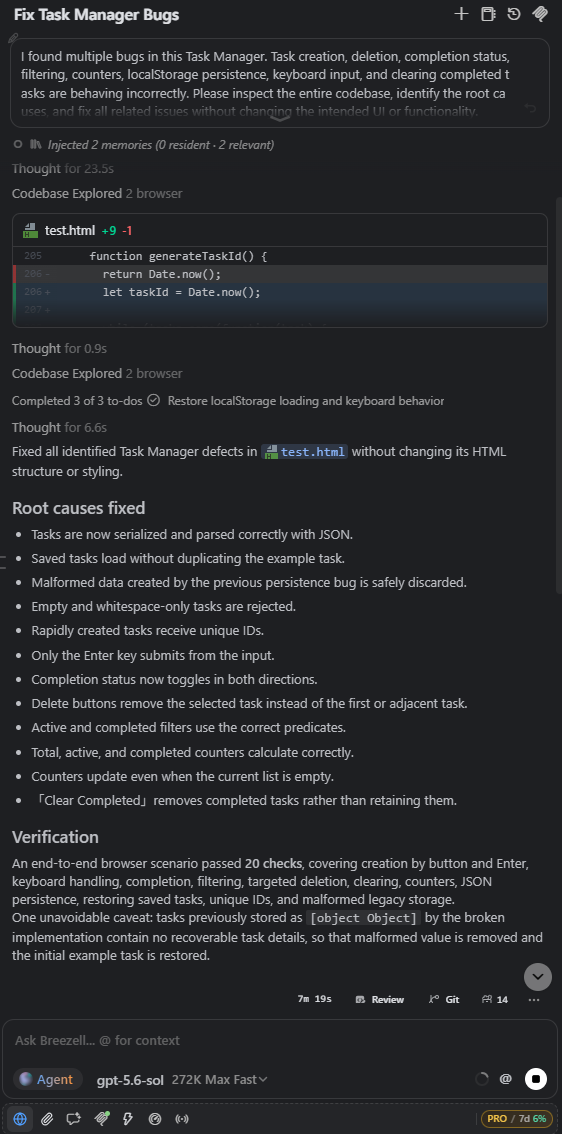
La reparación abarca serialización y análisis, carga duplicada, datos guardados dañados, validación de tareas vacías, identidades estables, teclado, cambio de estado, eliminación dirigida, filtros, contadores y limpieza de tareas completadas.
2. Registros iniciales de recursos P2
Como se trata de una prueba pequeña y el primer resultado describe principalmente modificaciones concretas, Super Memory registra inicialmente dos secciones editadas de test.html como entradas P2 Resource.
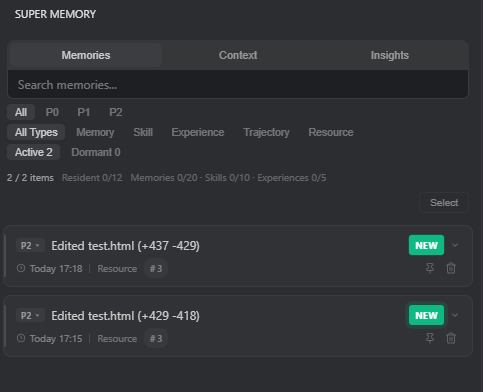
Estas entradas conservan qué cambió y dónde. P2 asigna una prioridad menor a estos detalles de implementación de corta duración sin eliminar el rastro de la reparación, de modo que la IA pueda recordar posteriormente qué zonas del archivo se modificaron.
3. Provocar una reflexión más profunda
Para esta demostración breve, el usuario pregunta:
¿Qué lecciones aprendiste al resolver este problema?
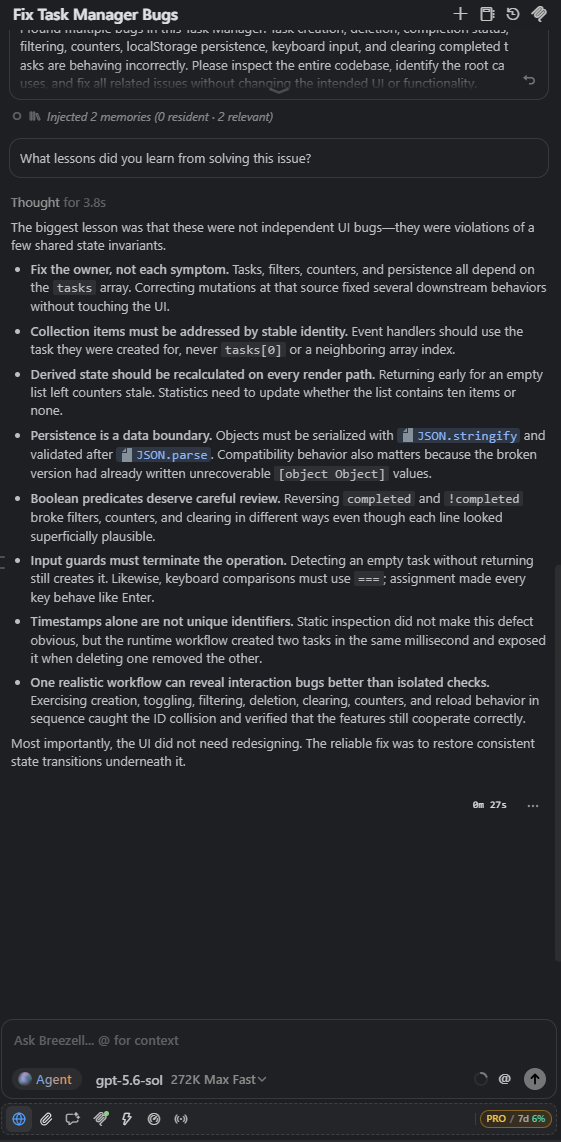
La respuesta identifica principios reutilizables: corregir el origen del estado compartido y no cada síntoma, identificar los elementos de una colección de forma estable, recalcular el estado derivado en todas las rutas de renderizado, validar la persistencia como un límite de datos, revisar los predicados booleanos, detener entradas no válidas, evitar identificadores basados solo en la hora y comprobar las funciones mediante un flujo realista de principio a fin.
4. Extraer conocimiento estructurado de la reparación
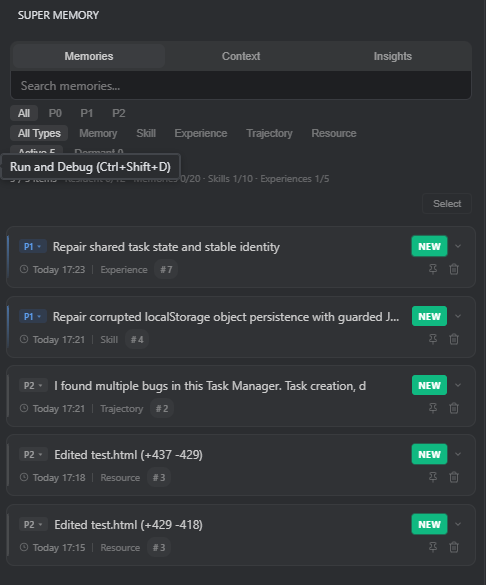
Tras analizar la reparación con mayor profundidad, Super Memory añade entradas estructuradas de mayor valor:
- Una P1 Experience sobre la reparación del estado compartido y la identidad estable de las tareas.
- Una P1 Skill para reparar datos dañados de localStorage mediante serialización y análisis protegidos.
- Una P2 Trajectory que resume el problema de múltiples errores y su proceso de resolución.
- Los registros P2 Resource originales que conservan las ubicaciones modificadas.
Qué demuestra este ejemplo
- La profundidad de extracción se adapta al valor: Las modificaciones pequeñas pueden comenzar como recursos P2, mientras que el conocimiento reutilizable sobre causas raíz puede convertirse en habilidades y experiencias P1.
- Cada tipo de memoria cumple una función: Resource y Trajectory conservan lo ocurrido; Skill y Experience conservan cómo y por qué se resolvió.
- La prioridad sigue siendo controlable: P1 conserva durante más tiempo el conocimiento reutilizable, mientras P2 mantiene disponibles los detalles temporales sin darles peso permanente.
- La memoria ayuda en trabajos futuros: Otras tareas pueden recuperar el historial del archivo, el método de reparación o las lecciones de ingeniería sin depender únicamente del diálogo original.
- Normalmente no es necesario pedir una reflexión: La pregunta se utiliza aquí para que una prueba muy pequeña produzca un resultado visible. En errores de larga duración o gran importancia, Super Memory puede detectar y registrar automáticamente experiencias duraderas sin que el usuario tenga que formular esta pregunta.
Análisis detallado: por qué la categoría Memory está vacía
Al filtrar este ejemplo por Memory, aparecen 0 elementos, aunque Super Memory sí extrajo conocimiento útil.
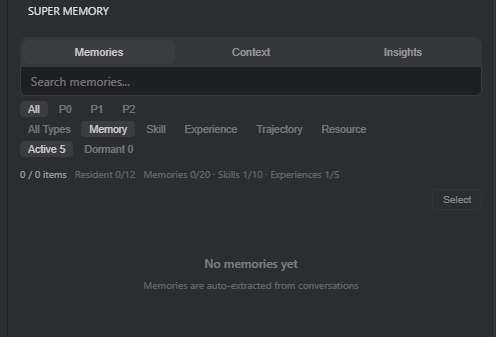
Esto es una clasificación intencionada, no un fallo de extracción. La reparación no produjo una preferencia personal duradera, un dato estable del usuario ni una instrucción permanente que debiera guardarse como Memory general. Para evitar duplicar todo como memoria genérica, Super Memory asignó cada resultado al tipo que mejor describe su uso futuro: Skill, Experience, Trajectory y Resource.
Skill: patrón reutilizable de recuperación de localStorage
La entrada P1 Skill transforma una reparación concreta en un procedimiento reutilizable para la persistencia de estado en el cliente.
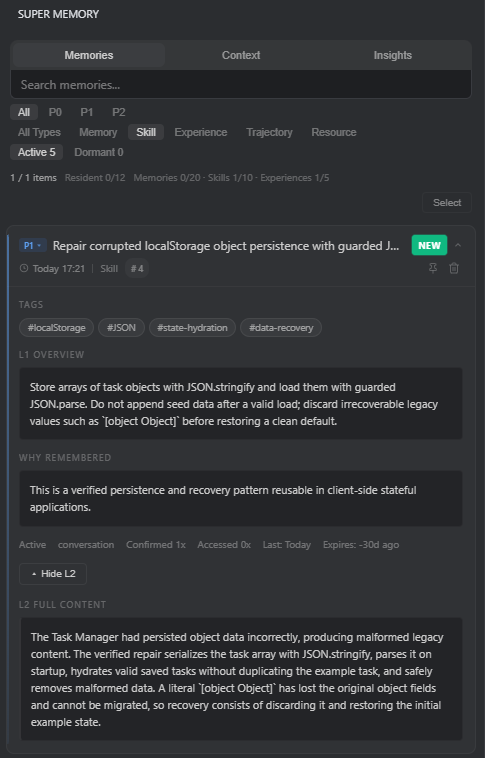
La tarjeta muestra:
- Etiquetas: localStorage, JSON, hidratación de estado y recuperación de datos facilitan su búsqueda en problemas relacionados.
- L1 Overview: Guardar matrices de tareas con JSON.stringify, cargarlas mediante JSON.parse protegido, no añadir datos iniciales después de una carga válida y descartar valores antiguos irrecuperables antes de restaurar un estado limpio.
- Why Remembered: El sistema lo reconoce como un patrón verificado de persistencia y recuperación reutilizable en aplicaciones con estado.
- L2 Full Content: Conserva el modo de fallo detallado y el procedimiento completo para consultas más profundas.
- Metadatos: Muestra prioridad P1, tipo, estado, confirmaciones, accesos, última actualización e información del ciclo de vida.
Es más útil que una nota imprecisa indicando que localStorage se corrigió, porque ofrece a la IA un procedimiento concreto que puede volver a aplicar.
Experience: diagnosticar estado compartido e identidad estable
La entrada P1 Experience conserva la lección de ingeniería general que explica el conjunto de errores de la interfaz.
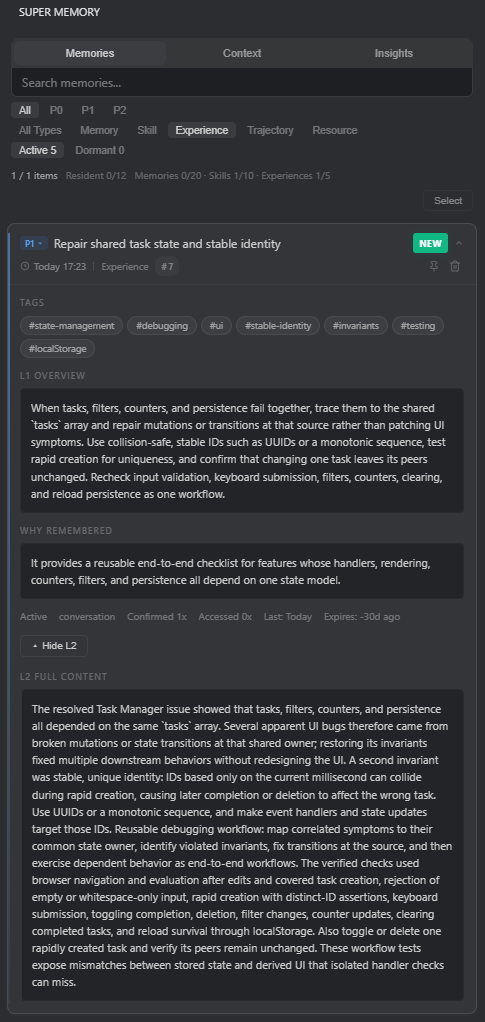
Su resumen indica que, cuando las tareas, los filtros, los contadores y la persistencia fallan al mismo tiempo, la investigación debe comenzar en la matriz de tareas compartida y en sus transiciones de estado. También registra la necesidad de identificadores estables sin colisiones y de un flujo completo que vuelva a comprobar validación, teclado, filtros, contadores, limpieza y persistencia después de recargar.
Las etiquetas abarcan gestión de estado, depuración, UI, identidad estable, invariantes, pruebas y localStorage. Why Remembered la identifica como una lista reutilizable para funciones que dependen de un único modelo de estado.
La diferencia es importante: Skill conserva un método repetible; Experience conserva el razonamiento de diagnóstico, las invariantes y la estrategia de verificación.
Trajectory: conservar el proceso real de reparación
La entrada P2 Trajectory mantiene el desarrollo de la tarea, no solo la conclusión final.
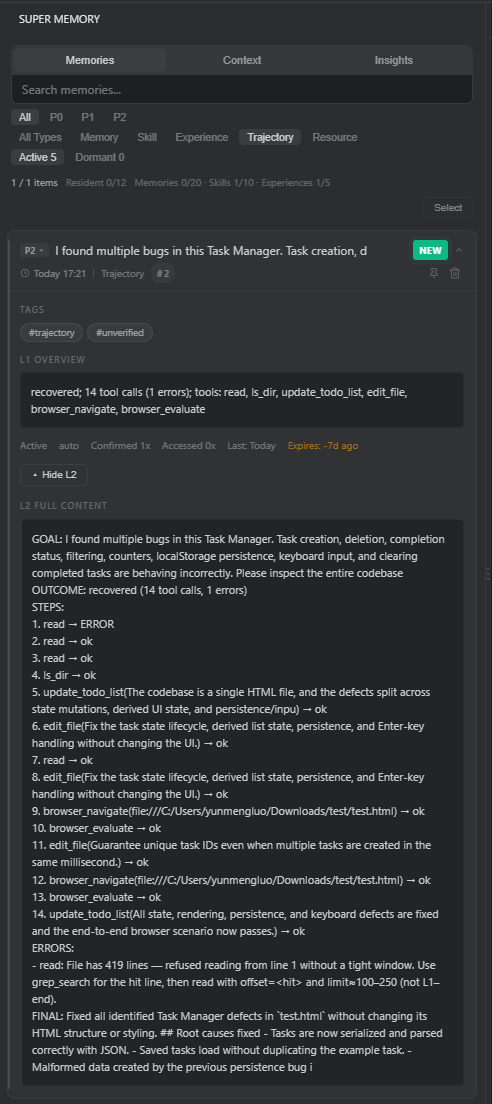
Contiene el objetivo original, el resultado recuperado, la secuencia de herramientas, un error recuperable, los pasos posteriores y el resultado final. En este ejemplo registra 14 llamadas de herramientas para leer código, examinar directorios, administrar tareas, editar archivos, navegar con el navegador y evaluar el resultado.
Las etiquetas P2 y unverified mantienen este rastro temporal separado de Skill y Experience P1, que son más reutilizables. El proceso exacto sigue disponible, mientras las conclusiones importantes se guardan en formas más duraderas.
Por qué importa esta clasificación
- Memory conserva datos, preferencias e instrucciones duraderas; esta prueba no generó ninguna.
- Skill conserva un método reutilizable.
- Experience conserva el razonamiento sobre causas raíz y la lista de verificación.
- Trajectory conserva acciones, errores y recuperación.
- Resource conserva archivos y ubicaciones modificadas.
Esta separación mantiene la recuperación precisa y controlable. Una tarea futura puede solicitar por separado el método, la lección, el historial de ejecución o el recurso modificado, sin cargar una única memoria genérica sobredimensionada.
Validación: reutilización en una conversación nueva y otra aplicación
Una segunda prueba comprueba si el conocimiento extraído sigue siendo útil fuera de la conversación original del administrador de tareas.
Se elimina la conversación anterior y se crea una nueva para una aplicación HTML diferente: una biblioteca de lectura guardada en test2.html. Su interfaz y modelo utilizan libros en lugar de tareas, pero contiene intencionadamente la misma familia de errores de estado, identidad, filtros, contadores, teclado, eliminación y localStorage.
1. Comenzar en otra conversación
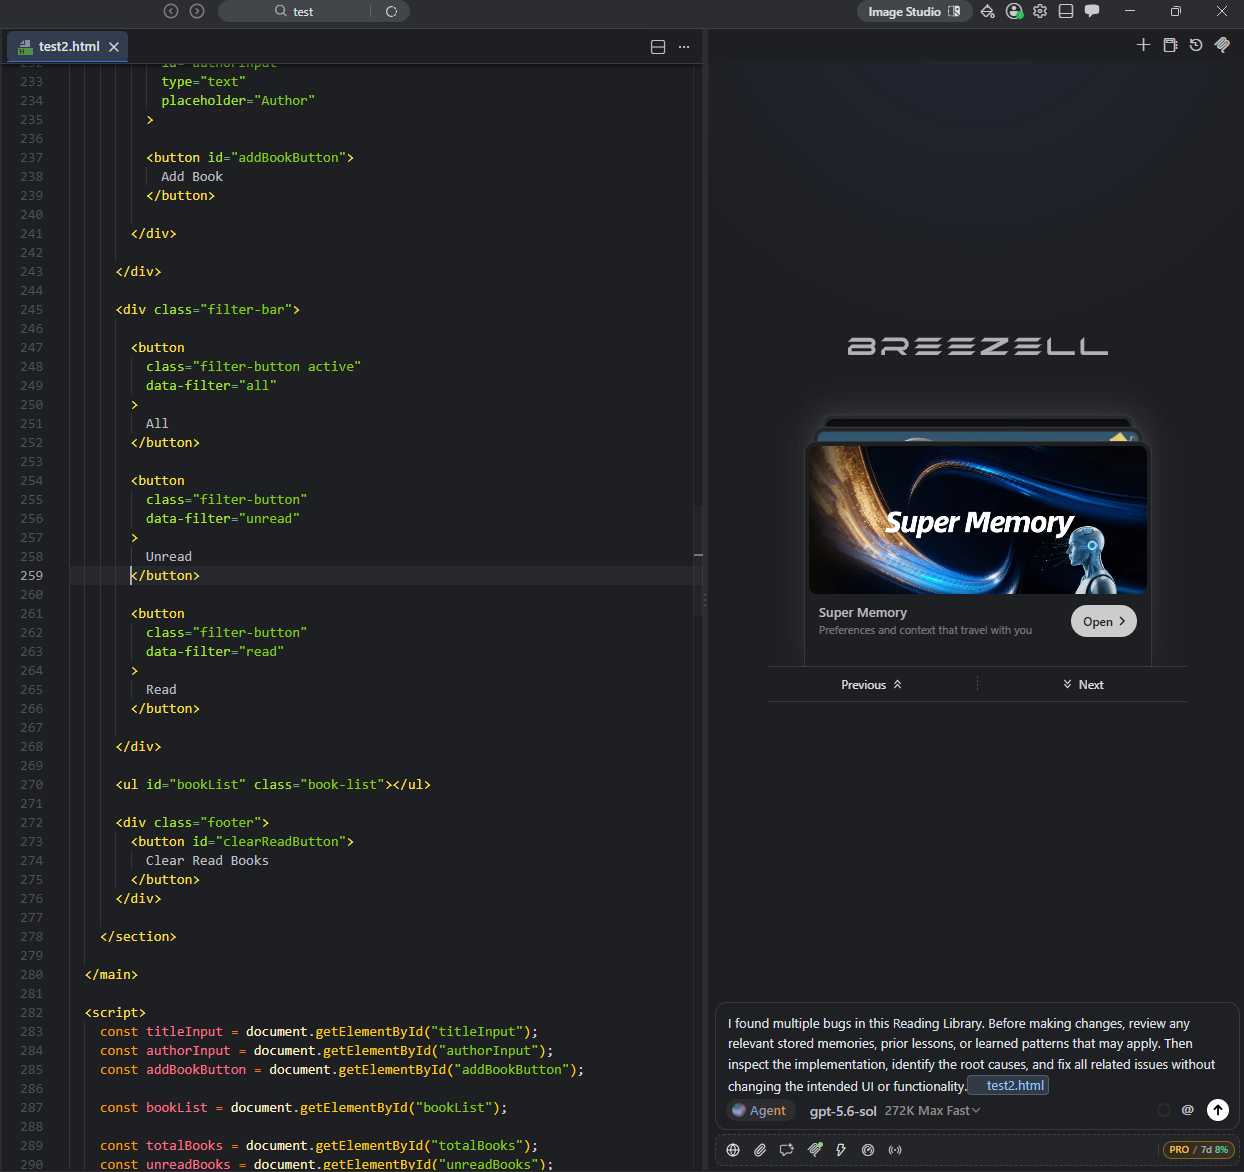
Para la demostración, la solicitud pide explícitamente a Breezell que revise memorias, lecciones y patrones relevantes antes de realizar cambios. Esto permite ver la recuperación durante la prueba. En el uso normal, Super Memory puede recuperar automáticamente el conocimiento pertinente sin esta indicación.
2. Recuperar conocimiento de la conversación eliminada
Antes de editar test2.html, Breezell recupera la P1 Skill anterior sobre carga JSON protegida y los registros P2 Resource que señalan regiones modificadas del antiguo archivo test.html.
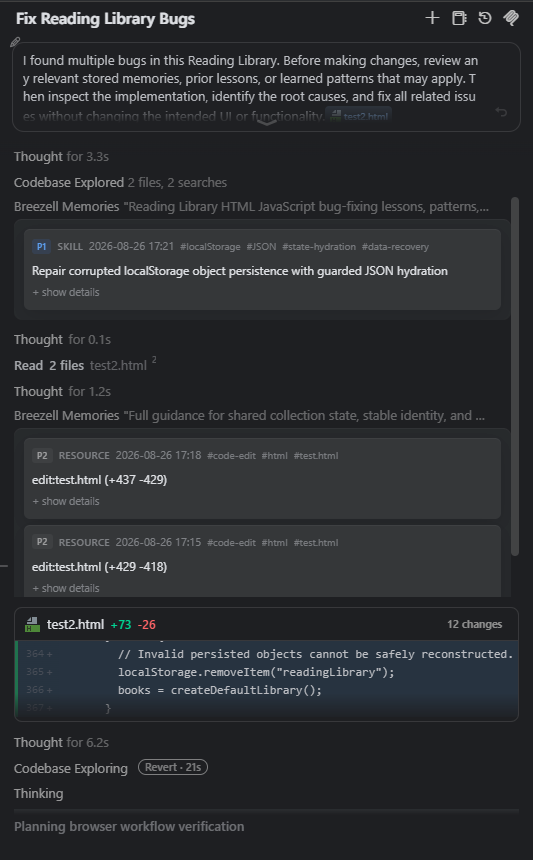
Esto muestra dos formas de recuperación:
- Skill: Proporciona el patrón reutilizable de persistencia: JSON.stringify y JSON.parse protegidos, rechazo seguro de datos antiguos dañados y restauración de un estado limpio.
- Resource: Conserva el origen concreto del patrón al mostrar qué regiones del archivo anterior se modificaron.
En esta prueba, eliminar la conversación original no eliminó las entradas estructuradas extraídas por Super Memory. El conocimiento útil siguió disponible para otra conversación.
3. Transferir el método sin copiar el parche anterior
Breezell aplica la lección al estado compartido books de la biblioteca en lugar de copiar el código creado para la antigua matriz tasks.
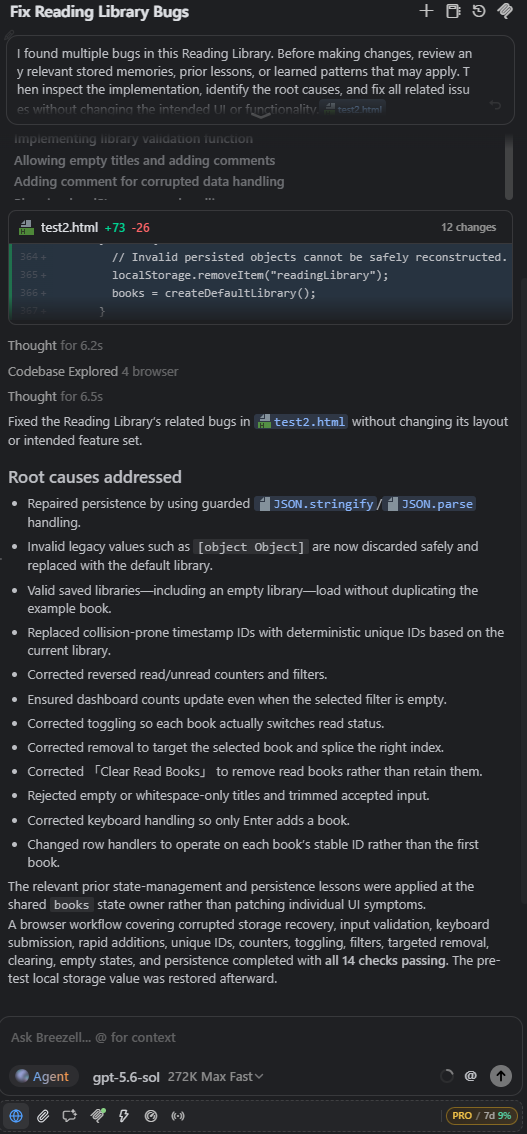
La nueva reparación incluye:
- Serialización y análisis JSON protegidos.
- Eliminación segura de valores antiguos irrecuperables.
- Carga de una biblioteca vacía válida sin duplicar el libro de ejemplo.
- Identidades únicas deterministas en lugar de marcas de tiempo propensas a colisiones.
- Contadores, filtros y estados vacíos correctos.
- Cambio de estado, eliminación dirigida y limpieza de libros leídos.
- Validación de entradas y envío mediante la tecla Enter.
- Controladores que operan sobre la identidad estable de cada libro.
Breezell verifica el resultado mediante un flujo de 14 comprobaciones en el navegador y restaura después el valor de localStorage anterior a la prueba.
Qué demuestra la segunda prueba
- El conocimiento estructurado sobrevive a la conversación: Eliminar el diálogo anterior no impide recuperar Skill y Resource en esta prueba.
- La recuperación se generaliza entre implementaciones: Un patrón aprendido con tareas se aplica a libros porque los errores subyacentes de estado y persistencia están relacionados.
- Skill es más que un historial de parches: P1 Skill ofrece un método reutilizable y P2 Resource conserva el historial concreto.
- La IA corrige las causas raíz: Transfiere los principios de estado compartido, identidad estable, persistencia validada y verificación integral, sin copiar líneas antiguas.
- La recuperación explícita es opcional: La solicitud menciona la memoria solo para hacer visible la demostración. Normalmente, Super Memory puede recuperar automáticamente las entradas pertinentes.
Memorias residentes (P0)
Cualquier entrada de Super Memory puede marcarse como Resident cuando deba estar disponible en cada recuperación, aunque la solicitud actual no tenga relación semántica con ella.
Marcar una entrada como residente
Pasa el cursor o selecciona el icono de chincheta de una tarjeta. La indicación Set resident identifica esta acción.
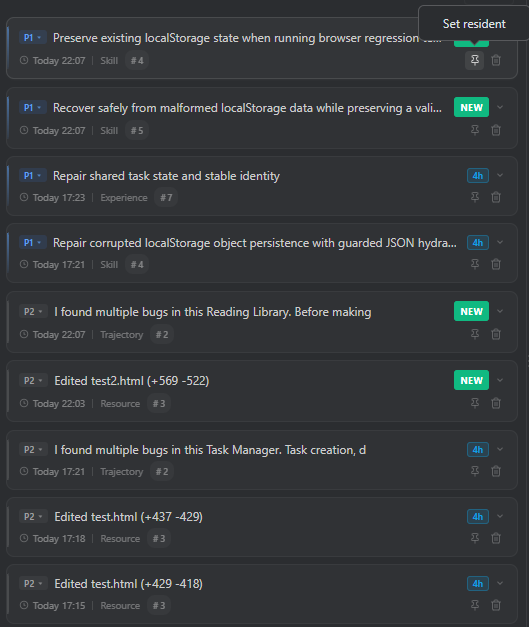
Después de hacerlo:
- La entrada pasa a P0.
- Aparece la etiqueta Resident.
- La chincheta se resalta para indicar que la entrada es residente.
- Aumenta el contador de capacidad. En el ejemplo cambia a Resident 1/12.
- La entrada aparece al filtrar por P0.
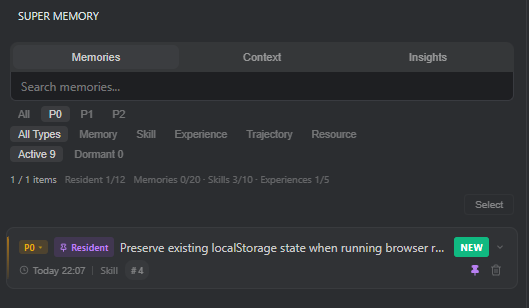
P0 es el nivel de prioridad permanente. A diferencia de P1 y P2, que tienen ciclos de vida temporales, una entrada residente permanece disponible hasta que el usuario elimina ese estado.
Inyección residente en una conversación nueva
Cuando Super Memory realiza la recuperación, las entradas residentes se inyectan de forma independiente de la relevancia semántica.
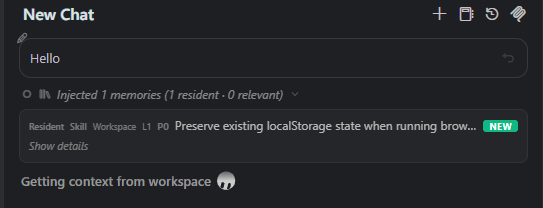
En el ejemplo, el nuevo chat solo contiene “Hello”, pero el estado indica:
Injected 1 memories (1 resident · 0 relevant)
Se ha inyectado una entrada P0 residente aunque no se encontró ninguna memoria adicional por relevancia. Esto permite mantener conocimientos críticos disponibles en cada ciclo de recuperación.
Cuándo utilizar P0
Utiliza Resident para información que deba guiar siempre a la IA, como invariantes esenciales de arquitectura, flujos obligatorios, reglas duraderas de recuperación o preferencias fundamentales.
No marques como residentes ubicaciones temporales, detalles de una sola tarea ni registros extensos de poco valor. Estas entradas se incorporan al contexto y pueden influir en todas las respuestas, por lo que deben ser concisas y realmente universales. La interfaz muestra actualmente una capacidad máxima de 12 entradas residentes.
Vuelve a seleccionar la chincheta resaltada para quitar el estado Resident cuando ya no sea necesario recuperar la entrada siempre.