
Super Memory
Super Memory(超级记忆) 是 Breezell 独立研发的记忆系统。它使用 Breezell 内置的两个模型从对话中提取有价值的信息,具体模型名称暂不公开。
记忆提取由 Breezell 内部模型管线完成,不会消耗用户所配置模型的 Token,也不会占用用户的模型 Token 额度。
可以提取的内容
超级记忆会将提取到的信息整理为以下类型:
- Memory(记忆): 可能在后续任务中继续使用的稳定事实、个人偏好、长期指令和重要决定。
- Skill(技能): 在任务过程中发现的可复用方法或工作流程。
- Experience(经验): 从过往工作中获得的结果、教训和实践知识。
- Trajectory(轨迹): 一项任务、决定或目标随时间推进的过程。
- Resource(资源): 与工作有关的文件、链接、工具或参考资料。
系统会自动从对话中提取和分类这些内容,以便在后续对话中将相关信息重新作为上下文使用。
浏览和筛选记忆
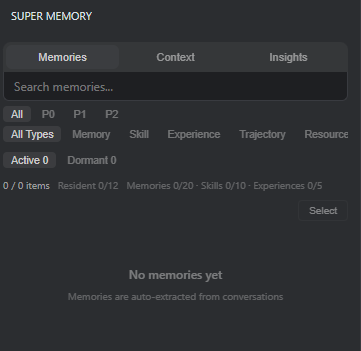
面板提供以下视图和操作:
- Memories、Context 和 Insights: 分别查看已提取的记忆、组合后的上下文以及基于记忆生成的整体洞察。
- 搜索: 通过文本查找已经保存的内容。
- 优先级: 按 P0、P1 或 P2 筛选,也可以查看全部优先级。
- 类型: 按 Memory、Skill、Experience、Trajectory 或 Resource 筛选。
- 状态: 分别查看 Active(活跃) 和 Dormant(休眠) 内容。
- 容量统计: 查看总条目数,以及常驻条目、记忆、技能和经验的当前容量占用。
- Select(选择): 进入选择模式,对指定条目进行管理。
没有任何条目时,面板会提示记忆将从对话中自动提取。随着对话继续,有价值的内容会自动出现在这里,不需要用户逐条手动编写。
核心优势
Super Memory 将强大的自动提取能力与高效、可控的记忆检索结合在一起:
- 强大的记忆提取: Breezell 内部的两个模型会分析对话,并将有价值的信息自动整理为 Memory、Skill、Experience、Trajectory 和 Resource 等结构化条目,无需用户手动录入。
- 高效的记忆检索: 系统会结合类型、优先级、状态、新鲜度和已经编译的记忆索引,将检索范围集中到与当前任务有关的信息,而不是无差别处理所有记忆。
- 可控的上下文注入: Context 页面会显示当前轮次实际注入的记忆快照、下一轮记忆索引预览及其估算 Token 数量。
- 明确的生命周期管理: P0 永久、P1 30 天和 P2 7 天优先级可配合 Active 与 Dormant 状态使用,在长期保留重要知识的同时,缩短临时信息的生命周期。
- 可观察的知识健康状态: 可以检查编译状态、源版本与编译器版本、过期资源、编译失败、验证与修正、内容新鲜度和未同步数量。
- 清晰的 Token 使用情况: 记忆提取不会消耗用户配置模型的 Token。被检索到的记忆注入请求后,会成为该请求上下文的一部分;索引预览和节省统计可以让这部分用量保持可见。
上下文与检索控制
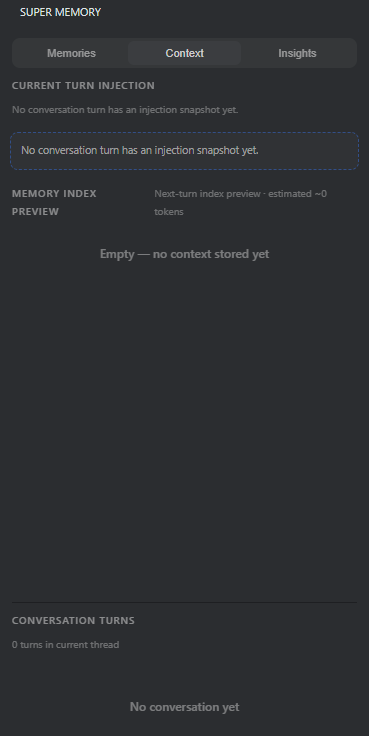
Context 页面用于查看记忆如何参与对话:
- Current Turn Injection(当前轮次注入): 显示实际注入当前对话轮次的记忆快照。尚未生成快照时,页面会明确显示空状态。
- Memory Index Preview(记忆索引预览): 预览为下一轮准备的记忆索引,并估算其 Token 数量,便于判断检索规模。
- Conversation Turns(对话轮次): 显示当前对话线程的轮次数量,并用于检查每轮对话的记忆活动。
这些信息让记忆检索过程保持可见和可控:用户可以确认本轮是否注入了记忆、下一轮将准备什么内容,以及大致会占用多少上下文。
洞察与系统健康状态
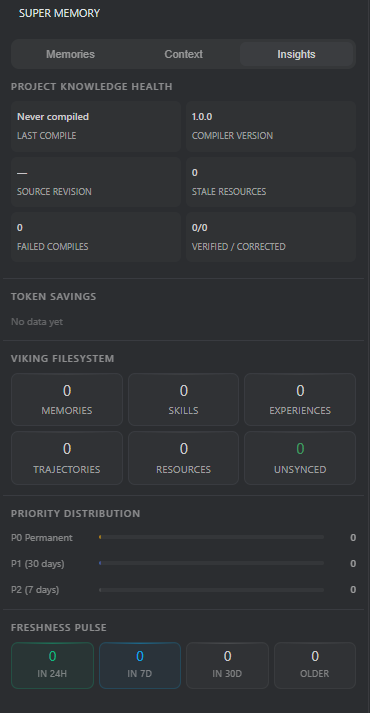
Insights 页面用于汇总记忆系统的状态和运行效果:
- Project Knowledge Health(项目知识健康状态): 显示最近编译时间、编译器与源版本、过期资源、编译失败次数,以及已验证或修正数量。
- Token Savings(Token 节省): 在积累足够的使用数据后显示 Token 节省情况。
- Viking Filesystem: 分别统计 Memories、Skills、Experiences、Trajectories、Resources 和 Unsynced 条目的数量。
- Priority Distribution(优先级分布): 显示 P0 永久、P1 30 天和 P2 7 天条目的分布。
- Freshness Pulse(新鲜度脉冲): 按 24 小时内、7 天内、30 天内和更早时间划分知识更新时间。
Context 和 Insights 让用户能够清晰了解 Super Memory 提取了什么、可能检索什么,以及已保存知识是否保持新鲜和健康。
活跃与休眠记忆
活跃记忆可以继续参与相关信息召回。休眠记忆仍然会被保留,但会与活跃集合分开,从而在保存可能有用信息的同时,让当前上下文保持聚焦。
实测演示:将一次修复转化为可复用记忆
本示例使用一套故意写错的 HTML Task Manager,展示 Super Memory 如何将一次短暂的修复过程转化为后续可复用的知识。
测试请求要求 AI 在不改变预期 UI 和功能的情况下,检查整个代码库,并修复任务创建、删除、完成状态、筛选、计数、localStorage 持久化、键盘输入和清除已完成任务等问题。
1. 检查并修复 Task Manager
Breezell 会检查代码、识别多个问题背后的共同根因、修复实现并验证完整操作流程,而不是将每个界面症状都当作互不相关的独立错误。
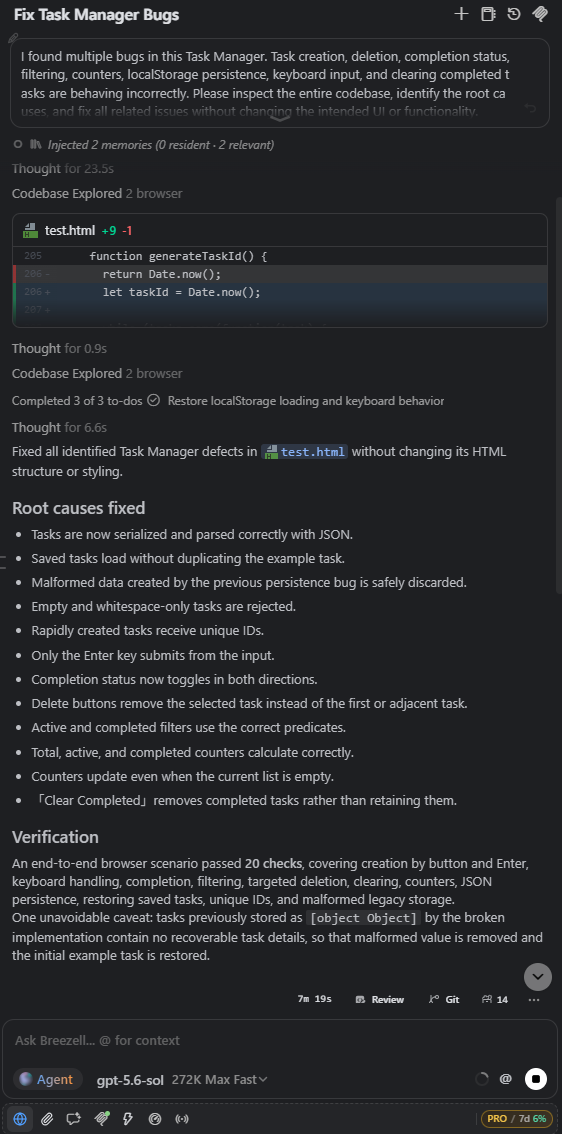
本次修复覆盖序列化与解析、重复加载、损坏的存储数据、空任务校验、稳定任务标识、键盘处理、完成状态切换、定向删除、筛选、计数器以及清除已完成任务。
2. 初步记录为 P2 Resource
由于这是一个规模较小的测试,而且第一阶段主要产生了具体的文件修改,Super Memory 最初只将 test.html 的两个编辑区域记录为 P2 Resource(资源)。
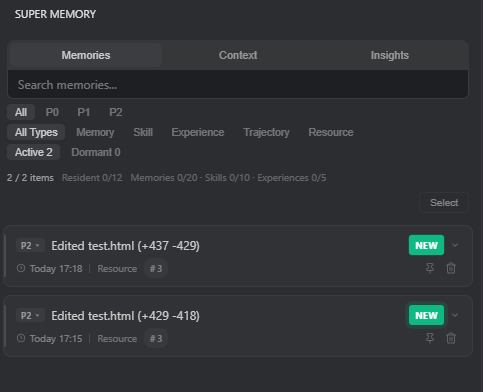
这些记录用于保存“修改了什么”和“修改发生在哪里”。P2 会给予这类短期实现细节较低优先级,但不会丢失修复轨迹;AI 以后仍然可以检索到修改过的文件区域。
3. 主动触发更深层的经验总结
为了让这个小型测试更明显地展示记忆提取效果,用户再次询问:
What lessons did you learn from solving this issue?
解决这个问题后,你学到了哪些经验?
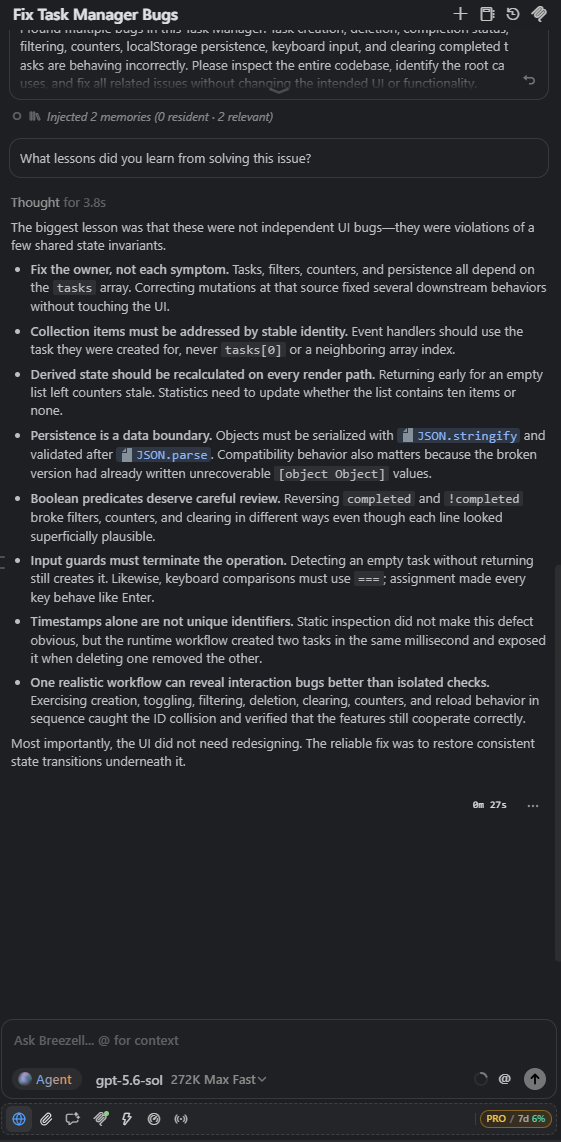
AI 从修复过程提炼出可复用的工程经验:应修复共享状态的源头而不是逐个处理症状;集合元素必须通过稳定标识操作;所有渲染路径都应重新计算派生状态;持久化层应作为需要验证的数据边界;布尔条件需要仔细检查;无效输入必须立即终止;时间戳不能单独作为可靠标识;完整的真实操作流程比孤立检查更容易发现交互问题。
4. 生成结构化修复记忆
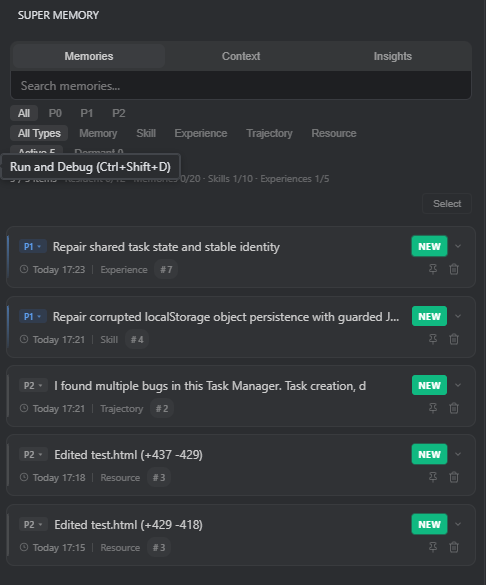
修复过程得到进一步重视后,Super Memory 会增加更有价值的结构化条目:
- 一条关于修复共享任务状态和稳定标识的 P1 Experience(经验)。
- 一条关于通过受保护的序列化与解析修复损坏 localStorage 持久化的 P1 Skill(技能)。
- 一条概括 Task Manager 多项问题及其解决过程的 P2 Trajectory(轨迹)。
- 原有的 P2 Resource(资源),继续保留具体文件修改位置。
这次演示说明了什么
- 记忆提取深度会随价值变化: 小型文件修改可能先记录为 P2 资源,而可复用的根因知识会进一步转化为 P1 技能和经验。
- 不同记忆类型承担不同作用: Resource 和 Trajectory 保存发生了什么;Skill 和 Experience 保存问题为什么发生以及应该如何解决。
- 记忆优先级保持可控: P1 会更长时间保留可复用修复知识;P2 则保留短期实现细节,但不会让其获得永久权重。
- 未来的 AI 任务可以直接受益: 后续任务可以检索相关文件历史、修复方法或工程经验,不必只依赖原始对话记录。
- 正常情况下不需要手动追问: 本次追问只是为了让一个规模很小的测试快速产生明显结果。如果遇到长周期或具有长期价值的问题,Super Memory 会更加智能地自动识别并记录修复经验,无需用户再次询问。
深入分析:为什么 Memory 中没有任何内容
在本次测试中筛选 Memory(记忆) 后,可以看到条目数量为 0,但这并不代表 Super Memory 没有成功提取内容。
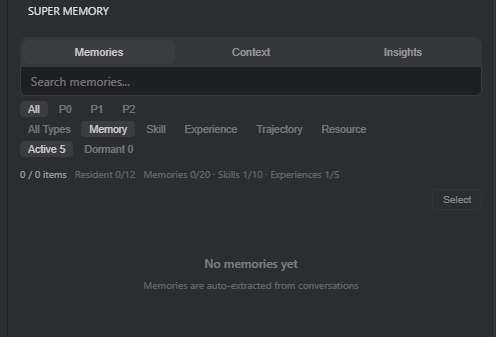
这是系统主动进行语义分类的结果,而不是记忆提取失败。本次修复没有产生适合长期保存为普通 Memory 的个人偏好、稳定用户事实或长期指令。Super Memory 不会把所有内容重复塞进普通记忆,而是根据未来用途,将修复结果分别归类为 Skill、Experience、Trajectory 和 Resource。
Skill:可复用的 localStorage 修复方法
系统将这次具体修复总结为一条 P1 Skill(技能),使其成为以后可以再次调用的客户端状态持久化处理方法。
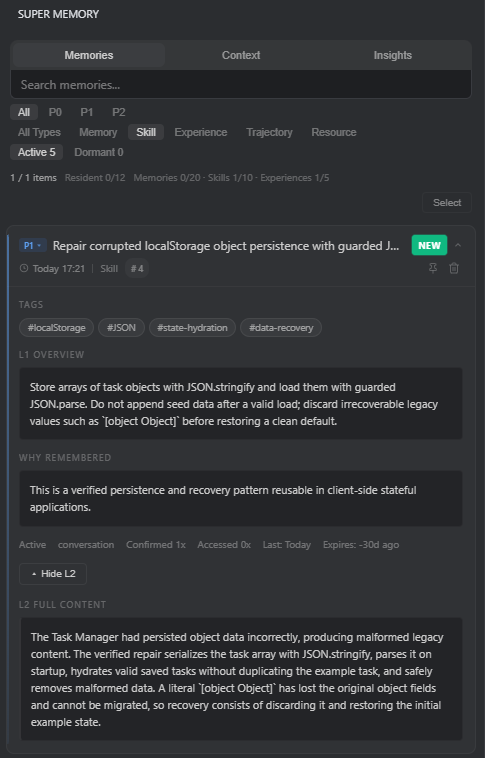
技能卡片包含:
- 标签: localStorage、JSON、状态恢复和数据恢复等标签,便于未来遇到相关问题时准确检索。
- L1 Overview(一级概览): 使用 JSON.stringify 保存任务数组,通过受保护的 JSON.parse 加载数据;成功加载后不再追加示例数据;遇到无法恢复的旧版错误值时,将其丢弃并恢复干净的默认状态。
- Why Remembered(记忆原因): 系统认为这是一套经过验证、可在客户端有状态应用中复用的持久化与恢复模式。
- L2 Full Content(二级完整内容): 保存具体故障原因以及完整的恢复过程,在需要深入检索时提供更详细的信息。
- 状态信息: 展示 P1 优先级、类型、活跃状态、确认次数、访问次数、最近更新时间和生命周期。
这比简单记录“修复了 localStorage”更有价值,因为未来的 AI 可以直接获得一套能够再次应用的具体处理方法。
Experience:共享状态与稳定标识的排错经验
系统还生成了一条 P1 Experience(经验),保存多个界面问题背后的系统性工程经验。
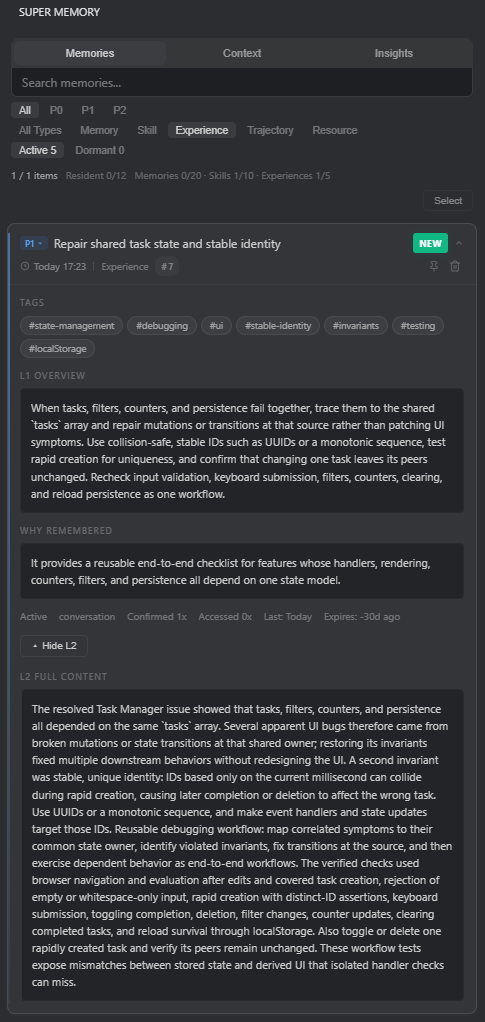
一级概览指出:当任务、筛选、计数器和持久化同时出现问题时,应从它们共同依赖的 tasks 数组和状态转换入手,而不是分别修补界面症状。同时应使用不会发生碰撞的稳定标识,并将输入校验、键盘提交、筛选、计数、清除以及重新加载后的持久化作为一个完整流程重新测试。
标签涵盖状态管理、调试、UI、稳定标识、不变量、测试和 localStorage。Why Remembered 说明这是一套可以复用的端到端检查清单,适用于事件处理、界面渲染、计数器、筛选和持久化共同依赖同一状态模型的功能。
Skill 保存的是可以重复执行的修复方法;Experience 保存的则是根因判断、系统不变量和验证策略。
Trajectory:保留真实的修复轨迹
系统提取的 P2 Trajectory(轨迹) 不只保存最终结论,还记录任务实际如何推进。
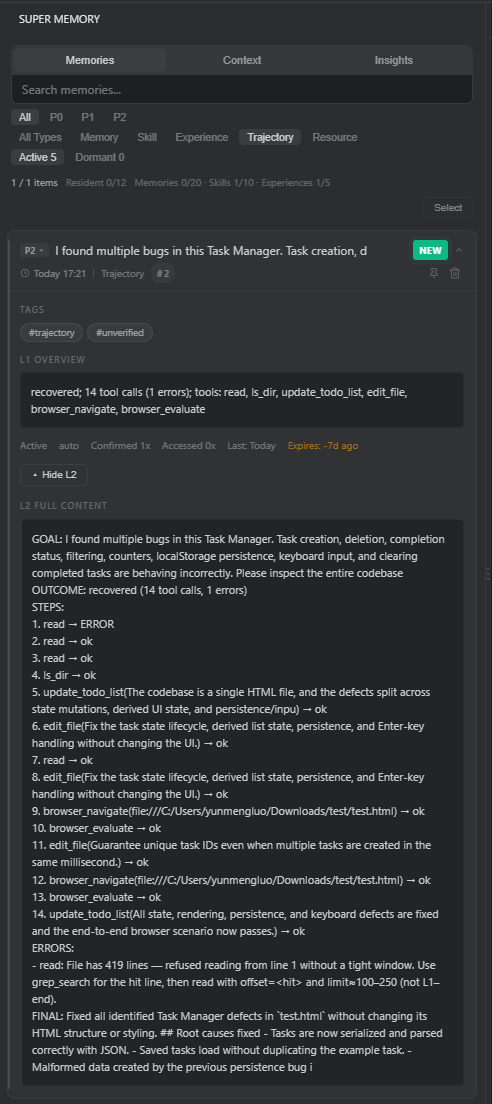
其中包含原始目标、恢复后的结果、工具调用顺序、一次可恢复错误、后续成功步骤和最终结果。本次轨迹共记录 14 次工具调用,涉及读取代码、检查目录、管理任务列表、编辑文件、浏览器导航和浏览器验证。
P2 和 unverified 标签将这类短期执行轨迹与更具复用价值的 P1 Skill、Experience 分开。AI 需要检查准确修复过程时仍可以检索该轨迹,而更重要的结论则以生命周期更长的形式保存。
为什么这种分类很重要
- Memory: 保存长期事实、个人偏好和持续有效的信息;本次测试没有生成这类内容。
- Skill: 保存以后可以再次调用的具体解决方法。
- Experience: 保存根因判断、工程不变量和验证清单。
- Trajectory: 保存操作步骤、错误以及恢复过程。
- Resource: 保存具体文件及修改位置。
这种分离让记忆检索更加精准、更加可控。未来任务可以分别提取修复方法、工程经验、执行历史或修改资源,而不需要加载一条内容庞杂的通用记忆。
二次验证:在新对话和不同应用中复用记忆
第二次测试用于验证:已经提取的知识是否能够脱离原来的 Task Manager 对话,在新的任务中继续发挥作用。
测试时先删除旧对话,再创建一个全新的对话,并使用结构不同的 HTML Reading Library——test2.html。它处理的是图书而不是任务,但故意保留了相同类型的状态管理、稳定标识、筛选、计数、键盘操作、删除和 localStorage 持久化问题。
1. 从独立的新对话开始
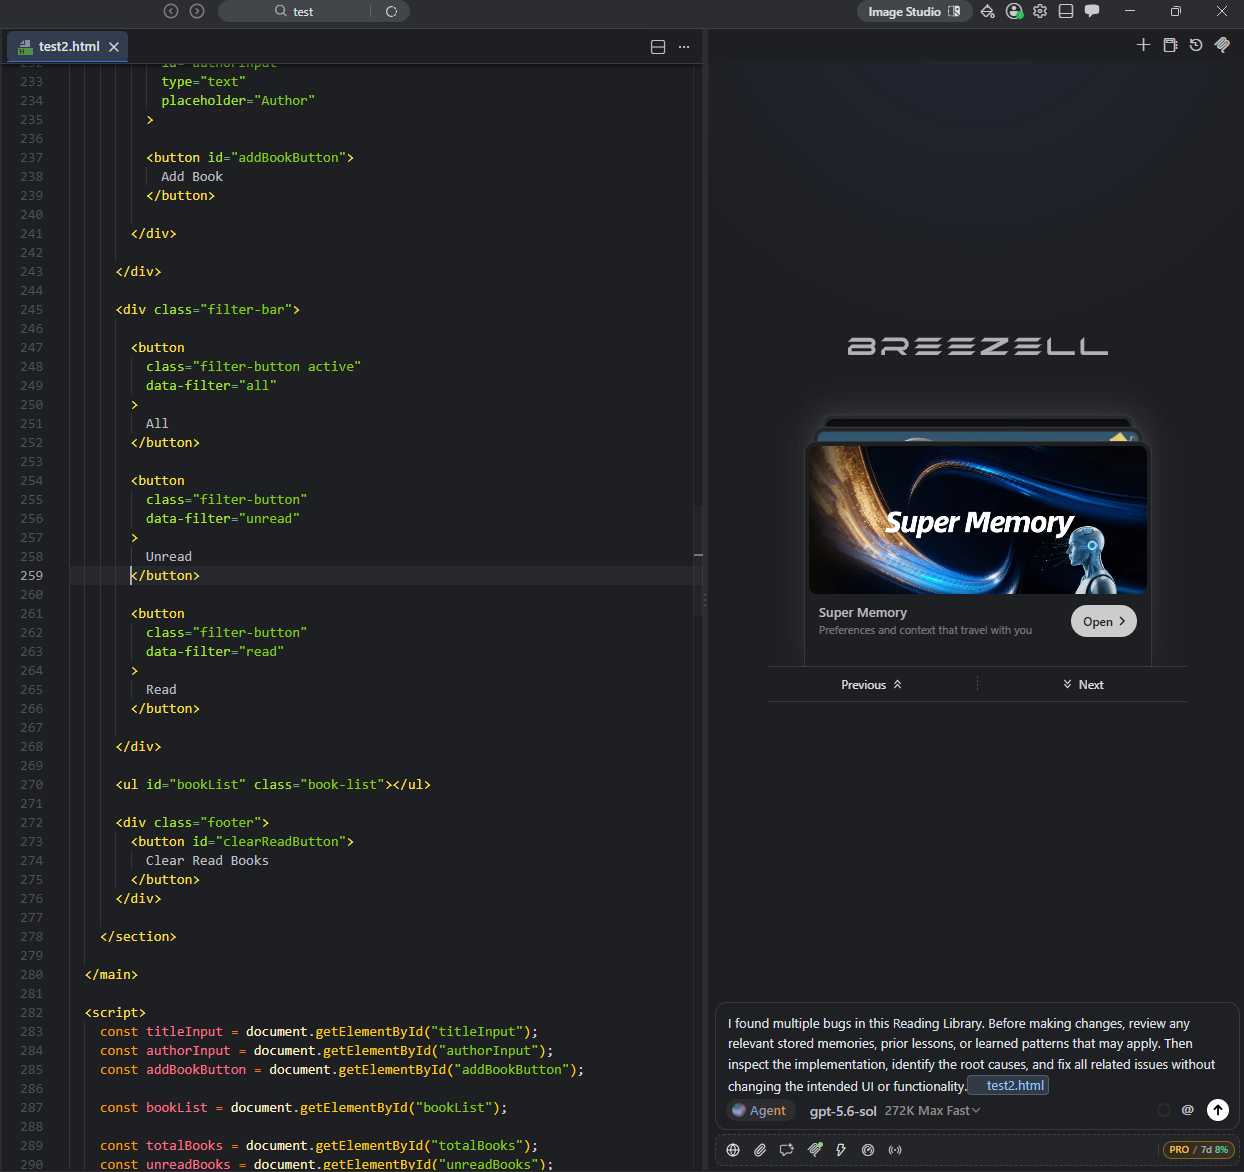
为了让演示过程更加直观,本次提示词明确要求 Breezell 在修改前查看相关记忆、历史经验和已经学到的解决模式。正常使用时不需要写出这项要求,Super Memory 会根据当前问题自动召回相关内容。
2. 从已删除的旧对话中召回知识
在编辑 test2.html 之前,Breezell 成功召回了之前生成的 P1 Skill(技能),以及指向旧文件 test.html 修改区域的 P2 Resource(资源)。
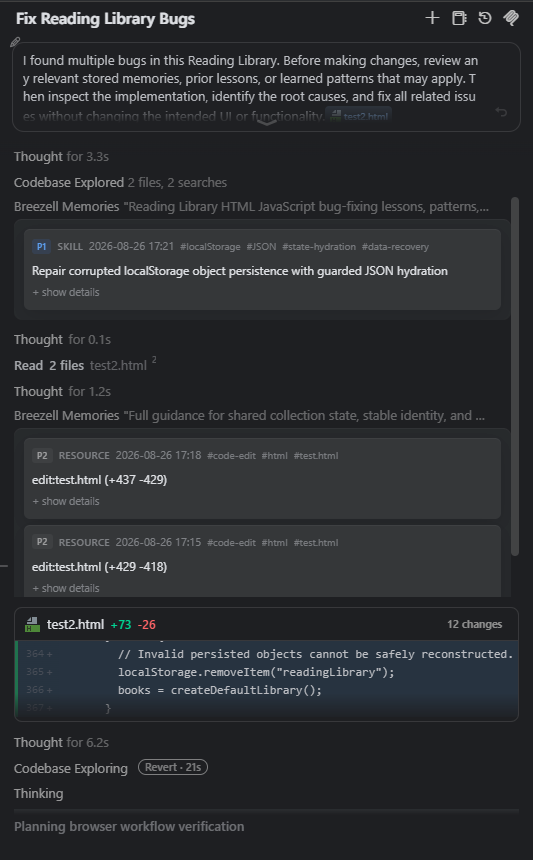
这次召回包含两类不同价值的信息:
- Skill 召回: 提供可以复用的持久化修复方法,包括受保护的 JSON.stringify 与 JSON.parse、损坏旧数据的安全丢弃以及干净默认状态的恢复。
- Resource 召回: 保留该解决模式最初来自哪里,展示之前修改过的旧文件区域。
在本次测试中,删除原始对话并没有删除从中提取出的结构化 Super Memory 条目。真正有价值的知识仍然可以被后续的新对话使用。
3. 迁移解决方法,而不是复制旧补丁
Breezell 没有将旧 tasks 数组的代码直接复制到新项目,而是把之前学到的原则应用到 Reading Library 共同依赖的 books 状态模型中。
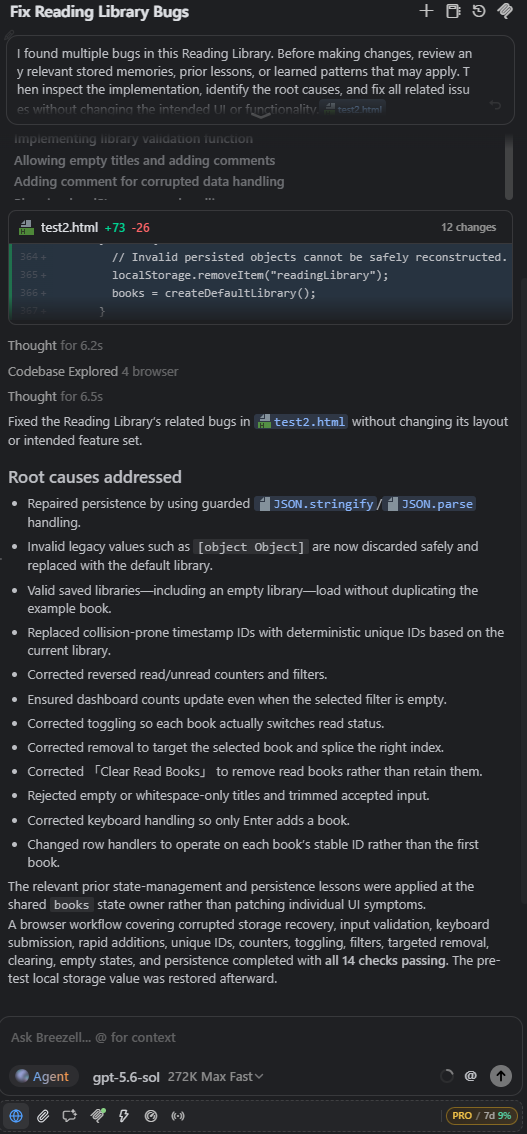
本次新修复包括:
- 受保护的 JSON 序列化与解析。
- 安全丢弃无法恢复的旧版错误数据。
- 正确加载空图书库,不重复添加示例图书。
- 使用确定且唯一的图书标识,替代可能碰撞的时间戳。
- 修复已读与未读计数、筛选和空筛选状态。
- 修复状态切换、定向删除和清除已读图书。
- 修复输入校验以及仅由 Enter 键提交。
- 让事件处理器通过每本书的稳定标识进行操作。
完成修改后,Breezell 使用包含 14 项检查的浏览器工作流程进行验证,并在测试结束后恢复原来的 localStorage 数据。
第二次测试证明了什么
- 结构化记忆可以脱离原始对话继续存在: 删除旧对话后,本次测试仍然成功召回了之前的 Skill 和 Resource。
- 记忆可以跨实现迁移: 从 Task Manager 学到的模式能够应用于完全不同的 Reading Library,因为两者底层的状态与持久化故障具有相同结构。
- Skill 不只是补丁历史: P1 Skill 提供的是可以再次使用的解决方法;P2 Resource 则保留具体实现历史作为辅助依据。
- AI 修复的是根因: 系统迁移了共享状态所有权、稳定标识、持久化数据边界和端到端验证原则,而不是逐行复刻旧代码。
- 不需要显式要求召回: 本次提示词要求使用记忆,只是为了让测试过程更容易观察。正常对话中,相关 Super Memory 条目会根据问题自动召回。
常驻记忆(P0)
任何 Super Memory 条目都可以设置为 Resident(常驻)。适合那些无论当前问题是否与其语义相关,都需要在每次记忆召回时保持可用的内容。
将条目设置为常驻
将鼠标移动到记忆卡片的图钉图标上,或直接点击该图标。悬浮提示 Set resident(设为常驻) 表示该操作。
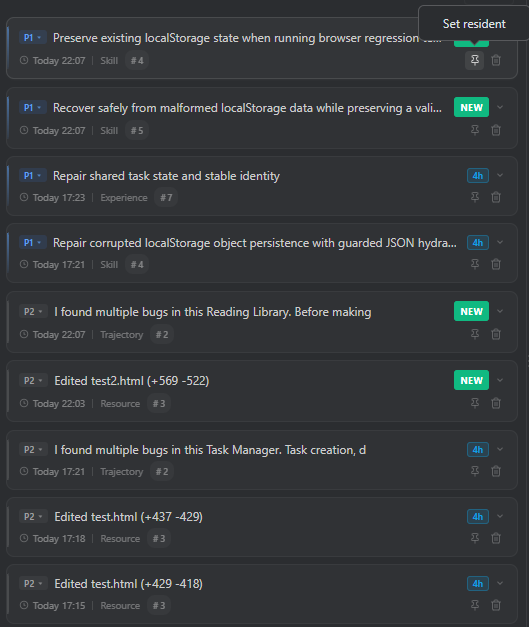
设置完成后:
- 条目优先级会提升为 P0。
- 卡片上会出现 Resident(常驻) 标记。
- 图钉会高亮,表示该条目处于常驻状态。
- 常驻容量计数会增加。本示例中变为 Resident 1/12。
- 使用 P0 筛选时可以看到该条目。
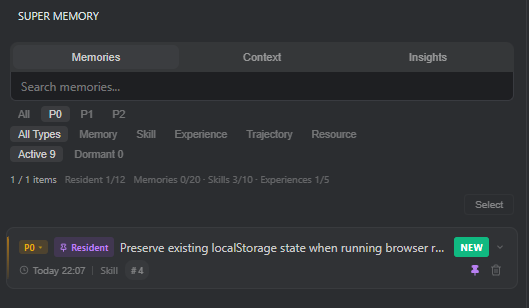
P0 是永久优先级。与具有时间生命周期的 P1 和 P2 不同,常驻条目会持续保持可用,直到用户主动取消其常驻状态。
在新对话中注入常驻记忆
Super Memory 执行召回时,常驻条目不会受到当前问题语义相关性的限制,而是独立注入。
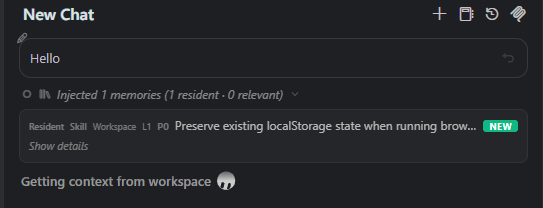
示例中的新对话只输入了“Hello”,但状态仍然显示:
Injected 1 memories (1 resident · 0 relevant)
这表示即使没有找到额外的相关记忆,系统仍然注入了一条 P0 常驻记忆。因此,常驻功能可以确保关键知识在每次记忆召回中稳定参与。
什么内容适合设置为 P0
适合常驻的内容包括关键架构不变量、必须遵守的工作流程、长期有效的恢复规则,以及始终需要的核心偏好。
不建议将临时文件位置、一次性任务细节或体积较大的低价值记录设为常驻。常驻条目会被注入请求上下文,并可能影响每次回答,因此内容应保持简洁并且真正具有通用性。目前界面显示最多可设置 12 条常驻记忆。
当某条内容不再需要每次召回时,再次点击高亮的图钉即可取消 Resident 状态。